Una base preparada para producción.
Diseñamos despliegue, observabilidad, seguridad y continuidad para que el software pueda operar y evolucionar con control.
Pasa el cursor o selecciona cualquier nodo para inspeccionar sus controles operativos.
Despliegues deterministas y repetibles con rollback automatizado si fallan las condiciones de salud.
Métricas, logs y trazas correlacionadas para entender el comportamiento real del sistema antes de especular.
Copias de seguridad verificadas con simulacros periódicos de restauración y objetivos RPO/RTO realistas.
Límites defensivos de recursos, aislamiento de red y runbooks claros para que el equipo tome el control sin fricción.
Producción empieza antes del deploy.
Un sistema no está listo porque compile o porque responda en una demo local. Está listo cuando sabemos con exactitud cómo desplegarlo, qué señales observar en vivo, qué perímetro proteger, qué respaldar y cómo recuperar el servicio cuando una dependencia o proveedor externo falla.
El código fuente es solo la mitad de la ecuación: la otra mitad es la arquitectura operacional que garantiza que permanezca disponible, seguro y trazable mientras recibe tráfico de usuarios y muta a través de nuevas versiones.
Las capas de una infraestructura operable.
Una arquitectura en producción no es un servidor monolítico ni un contenedor aislado: es una serie de capas coordinadas con límites de seguridad, aislamiento y responsabilidades operativas claras.
Controlar cómo entra y se distribuye el tráfico.
El perímetro de entrada gestiona la resolución DNS, la terminación TLS, el enrutamiento seguro y las defensas iniciales antes de que una petición alcance los servidores de aplicación.
- ✓ Resolución DNS y gestión de enrutamiento global
- ✓ Terminación TLS 1.3 y renovación automatizada de certificados
- ✓ Reverse proxy con balanceo de carga entre instancias
- ✓ Políticas perimetrales de rate limiting y cabeceras de seguridad (HSTS, CSP)
- ✓ Políticas de caché en el edge para activos estáticos y respuestas públicas
- ✓ Aislamiento estricto entre superficies públicas y endpoints privados
Ejecutar el software de forma predecible y reproducible.
Garantizamos que la aplicación corra en entornos consistentes e inmutables, con límites claros de recursos, variables segregadas y ciclos de vida de proceso controlados.
- ✓ Contenedores Docker optimizados y multicapa para builds reproducibles
- ✓ Segregación estricta de configuraciones y secretos por entorno
- ✓ Asignación defensiva de límites de memoria y cuotas de CPU
- ✓ Políticas de reinicio automático y reemplazo de instancias degradadas
- ✓ Aislamiento de procesos y ejecución bajo usuarios de mínimo privilegio
- ✓ Sondeos de arranque (startup probes) para evitar ráfagas en frío
Operar el software en marcha, no únicamente iniciarlo.
La aplicación debe informar de su estado interno, tolerar fluctuaciones de red y apagarse de forma ordenada sin perder transacciones en vuelo.
- ✓ Endpoints de salud desacoplados: comprobación de disponibilidad (readiness) y vida (liveness)
- ✓ Apagado ordenado (graceful shutdown) con drenado de conexiones activas
- ✓ Timeouts defensivos en todas las llamadas de entrada y dependencias
- ✓ Generación e inyección de Request ID para trazabilidad correlacionada
- ✓ Logs estructurados en formato JSON con niveles de severidad calibrados
- ✓ Patrones de disyuntor (circuit breaker) frente a servicios lentos
Proteger el estado que no se puede reconstruir fácilmente.
El código se puede redesplegar en segundos; los datos no. Diseñamos la capa de persistencia con alta integridad, control de migraciones y aislamiento de red.
- ✓ Bases de datos en redes privadas sin exposición directa a internet
- ✓ Gestión versionada y transaccional de migraciones de esquema
- ✓ Separación de roles de base de datos con mínimo privilegio operativo
- ✓ Cifrado de datos en reposo (AES-256) y en tránsito (TLS)
- ✓ Retención calibrada de transacciones (WAL/binlog) para recuperación point-in-time
- ✓ Pool de conexiones gestionado para proteger al motor contra saturación
Asumir que las dependencias externas también van a fallar.
Ningún proveedor externo tiene 100% de disponibilidad. Blindamos el sistema para que una caída de pasarela, correo o almacenamiento externo no tumbe la plataforma completa.
- ✓ Timeouts estrictos para no acumular conexiones pendientes en el servidor
- ✓ Reintentos exponenciales con fluctuación (jitter) para evitar efecto manada
- ✓ Degradación elegante: respuestas secundarias o encolado cuando la API externa no responde
- ✓ Monitoreo de latencia y tasas de error de terceros de forma segregada
- ✓ Manejo seguro de webhooks entrantes con validación de firmas criptográficas
- ✓ Aislamiento de credenciales de proveedores mediante vaults protegidos
Saber qué está ocurriendo antes de tener que adivinar.
Observabilidad no es un panel con números bonitos: es la capacidad de correlacionar métricas agregadas, trazas distribuidas y logs contextuales para entender un incidente.
- ✓ Telemetría estructurada: métricas clave de tasa, errores y duración (RED / USE)
- ✓ Logs centralizados e indexados con enmascaramiento de datos personales (PII)
- ✓ Trazas distribuidas que identifican con exactitud qué salto introduce latencia
- ✓ Alertas basadas en síntomas de usuario (SLIs) y no en ruido transitorio
- ✓ Dashboards operacionales ordenados por capas del sistema
- ✓ Libros de ejecución (runbooks) vinculados a cada alerta crítica
Diseñar cómo volver a operar, no improvisarlo durante la emergencia.
La resiliencia se prueba en frío. Diseñamos procedimientos de restauración verificados, automatización de rollback y planes de contingencia documentados.
- ✓ Copias de seguridad automatizadas con almacenamiento fuera de sitio (offsite)
- ✓ Simulacros periódicos de restauración para validar la integridad del backup
- ✓ Rollback automatizado o despliegue rápido a la última versión estable conocida
- ✓ Definición documentada de objetivos de recuperación: RPO y RTO realistas
- ✓ Procedimientos de contingencia paso a paso para el equipo operativo
- ✓ Revisiones post-incidente orientadas a la causa raíz sin asignación de culpas
Desplegar rápido importa. Poder detenerse también.
Un pipeline de ingeniería debe acelerar el camino correcto y bloquear una versión cuando faltan condiciones para promoverla a los usuarios.
Identificar y validar el origen del cambio.
El pipeline se inicia cuando un commit validado por code review se fusiona en la rama protegida o se emite un tag formal de release.
Rama protegida con aprobación obligatoria y firmas de autor verificadas.
Commit SHA verificado con firma GPG en repositorio Git.
Ver un número no es lo mismo que entender un incidente.
Métricas, logs, errores y trazas tienen valor cuando ayudan a responder qué cambió, dónde ocurre y qué usuario o dependencia está afectada.
"¿Está cambiando el comportamiento agregado del sistema?"
Series temporales numéricas que miden la tasa de solicitudes, tiempos de respuesta (p50, p95, p99) y utilización de recursos (CPU, memoria, descriptores de archivo).
"¿Qué evento concreto reportó la aplicación o servicio?"
Líneas de evento contextuales emitidas en formato JSON con Request ID, timestamp de alta precisión, nivel de severidad y parámetros que no exponen datos sensibles (PII).
"¿En qué salto de una operación distribuida aparece la degradación?"
Propagación de contexto mediante cabeceras que miden con exactitud cuántos milisegundos consumió cada servicio (edge, router, API, base de datos, API externa).
"¿Qué tipo de fallo está ocurriendo y con qué alcance?"
Captura de excepciones no controladas, fallos tipados y respuestas HTTP 5xx agrupadas por frecuencia, impacto de usuarios y huella de stack trace.
"¿Qué condición merece interrumpir a una persona o iniciar una acción?"
Reglas calibradas basadas en síntomas reales de degradación para el usuario final (SLIs), evitando el agotamiento por fatiga de alertas falsas.
El fallo no se elimina. Se contiene y se recupera.
Ningún sistema en producción es invulnerable. La ingeniería de resiliencia define cómo detectar la anomalía en segundos, contener el impacto en un perímetro cerrado y restaurar el servicio con procedimientos seguros.
DESPLIEGUE CON DEGRADACIÓN
Una nueva versión de la aplicación se despliega pero introduce una fuga de memoria o un endpoint crítico que responde con errores 500 tras recibir tráfico inicial.
Detección automática por Readiness Probe
Las pruebas de preparación (readiness) detectan errores 500 consecutivos en /api/health.
Detención inmediata de la promoción
El pipeline bloquea el avance del despliegue e impide que el proxy derive más tráfico a la nueva versión.
Rollback automático y drenado
Se ejecuta el rollback automático a la versión estable previa y se destruyen las instancias defectuosas.
Confirmación de telemetría y post-mortem
Se verifica la recuperación de la tasa de éxito al 100% y se preservan los logs del contenedor para análisis.
CAÍDA DE PROVEEDOR EXTERNO
Una API externa crítica (pasarela de pagos, servicio de facturación o proveedor de SMS) sufre una degradación masiva y deja de responder.
Detección de latencia en socket saliente
La duración de llamadas hacia el proveedor externo supera el umbral límite configurado de 4000ms.
Apertura del disyuntor (Circuit Breaker)
El disyuntor se abre tras 5 timeouts consecutivos, cortando llamadas síncronas al proveedor caído.
Encolado asíncrono y reintentos con backoff
Las operaciones se derivan a una cola persistente en Redis (BullMQ) para reintento con retroceso exponencial.
Cierre gradual del circuito y vaciado de cola
Al detectar que el proveedor externo recupera disponibilidad (half-open), se procesa la cola acumulada.
CAÍDA DE INSTANCIA O PROCESO
Un proceso de aplicación sufre una excepción catastrófica no capturada (Out of Memory OOM o fallo de segmentación) y se detiene repentinamente.
Fallo de Liveness Probe y desconexión de socket
El supervisor de runtime detecta que el proceso de la instancia dejó de responder a la sonda de vida.
Retiro inmediato del pool del reverse proxy
El reverse proxy deja de enviar tráfico a la instancia caída en menos de 500 milisegundos.
Aprovisionamiento y arranque de instancia nueva
El runtime inicia un contenedor de reemplazo a partir de la imagen inmutable registrada en el registry.
Pase de Readiness Probe y reintegración de tráfico
La nueva instancia completa su inicialización, pasa las comprobaciones de salud y reanuda recepción de tráfico.
SATURACIÓN DE BASE DE DATOS
Un pico inusual de tráfico genera cientos de consultas concurrentes que amenazan con agotar el pool de conexiones del motor PostgreSQL.
Saturación del 85% en Connection Pool
El monitor de base de datos detecta que las conexiones activas superan el umbral de alerta operativo.
Activación de Rate Limiting y caché de lectura
El edge activa rate limiting restrictivo y entrega respuestas públicas desde caché para aliviar la BD.
Reutilización agresiva de conexiones (Pooler)
El connection pooler multiplexa peticiones transaccionales evitando abrir nuevos procesos en el motor PostgreSQL.
Normalización de latencia y liberación de memoria
La cola de transacciones se drena a niveles normales (<10ms) y el sistema restaura los límites habituales.
No todo debe poder hablar con todo.
La seguridad perimetral y operativa consiste en segmentar superficies, aislar redes privadas, proteger secretos y aplicar el principio de mínimo privilegio en cada interfaz de conexión.
Superficie pública mínima y aislamiento de puertos.
Solo el reverse proxy en el edge expone puertos públicos hacia internet (80/443). Ningún servicio interno, base de datos o puerto administrativo es accesible directamente.
Tráfico HTTPS validado dirigido a rutas registradas en el reverse proxy.
Acceso directo por IP a contenedores de aplicación, puertos de base de datos o consolas SSH sin VPN.
- ✓ Firewall perimetral y listas de control de acceso (ACLs)
- ✓ Reverse proxy con mapeo explícito de endpoints públicos
- ✓ Bloqueo estricto de puertos administrativos y de depuración
- ✓ Rate limiting y protección defensiva frente a ataques DDoS en capa 7
Mínimo privilegio y segregación estricta de roles.
Cada servicio, worker y desarrollador opera con los permisos estrictamente necesarios para su función. Cero credenciales compartidas ni accesos universales.
Tokens con scopes específicos y credenciales temporales con expiración automática.
Uso de claves maestras permanentes o permisos de administrador en procesos de aplicación.
- ✓ Roles de servicio con políticas de mínimo privilegio
- ✓ Acceso administrativo protegido por autenticación multifactor (MFA)
- ✓ Separación estricta entre credenciales de staging y producción
- ✓ Revocación inmediata y rotación periódica de accesos
Cero secretos en código y rotación periódica.
Las claves de API, certificados y cadenas de conexión nunca se almacenan en repositorios Git ni en imágenes de contenedor. Se inyectan en memoria en el momento del arranque.
Inyección de variables de entorno cifradas mediante almacenes seguros (Vaults / Secret Managers).
Secretos hardcodeados en archivos de configuración, logs de aplicación o frontend bundles.
- ✓ Almacenamiento centralizado en gestor de secretos con cifrado en reposo
- ✓ Inyección en memoria en runtime sin persistencia en disco
- ✓ Escaneo automatizado de código (secret linting) en el pipeline de CI
- ✓ Enmascaramiento obligatorio en logs estructurados y herramientas de observabilidad
Cifrado integral TLS 1.3 y cabeceras defensivas.
Toda comunicación en tránsito entre usuarios, reverse proxy y dependencias externas viaja obligatoriamente cifrada con algoritmos criptográficos modernos.
Conexiones TLS 1.3 con suites de cifrado seguras y redirección estricta de HTTP a HTTPS.
Protocolos inseguros (HTTP plano, TLS 1.0/1.1) o certificados autofirmados en producción.
- ✓ Renovación automática de certificados SSL/TLS antes de su vencimiento
- ✓ Cabeceras de seguridad estrictas: HSTS (max-age=31536000), CSP, X-Frame-Options
- ✓ Cookies con banderas Secure, HttpOnly y SameSite
- ✓ Cifrado TLS en el tráfico interno entre balanceador y workers de aplicación
Cifrado en reposo y aislamiento de red privada.
Los datos almacenados en bases de datos relacionales, Redis y buckets de almacenamiento se cifran en reposo con llaves gestionadas y controles de retención auditables.
Consultas procedentes de servidores de aplicación autenticados en la misma subred privada (VPC).
Peticiones de base de datos originadas fuera de la red interna o sin cifrado en tránsito.
- ✓ Cifrado de disco y tablas mediante algoritmo AES-256 en reposo
- ✓ Copias de seguridad cifradas antes de su transmisión al almacenamiento offsite
- ✓ Enmascaramiento de datos personales en entornos de prueba o staging
- ✓ Borrado seguro y purga automatizada de datos según políticas de retención
Trazabilidad inmutable de cambios y accesos.
Cada despliegue, acceso administrativo y cambio de configuración genera un registro auditable con identidad del autor, timestamp exacto y contexto de la operación.
Logs de auditoría protegidos contra escritura con preservación para cumplimiento regulatorio.
Modificaciones manuales directas en servidores de producción sin registro en pipeline o ticket.
- ✓ Trazabilidad de cada versión desplegada vinculada a un commit SHA inmutable
- ✓ Registro de accesos privilegiados con registro de comandos ejecutados
- ✓ Almacenamiento de logs de auditoría en repositorio inmutable (WORM)
- ✓ Alertas automáticas ante intentos repetidos de acceso no autorizado
Un backup que nunca se restauró sigue siendo una hipótesis.
Respaldar datos es el paso elemental; la verdadera resiliencia consiste en tener un procedimiento automatizado y probado para restaurar la operación en el tiempo que tu negocio requiere.
¿Cuánto estado operativo estamos dispuestos a perder?
Define la antigüedad máxima de los datos que se pueden perder ante una catástrofe. Con snapshots periódicos y archivado de logs transaccionales (WAL), el RPO se reduce de 24 horas a escasos minutos.
¿Cuánto tiempo puede pasar hasta que el servicio vuelva a operar?
Determina la velocidad con la que el equipo puede levantar un nuevo entorno, restaurar el snapshot y reconectar el tráfico. Un runbook probado y scripts listos evitan horas de parálisis en producción.
"¿Qué elementos del sistema son estrictamente indispensables para reconstruir la operación?"
El código fuente reside en Git y la infraestructura en código declarativo. El alcance de recuperación se concentra en los datos que no se pueden reconstruir desde cero.
- ✓ Bases de datos transaccionales (PostgreSQL / MySQL / Redis)
- ✓ Archivos de medios y documentos subidos por usuarios (Object Storage / S3)
- ✓ Variables de entorno y claves de descifrado resguardadas en vaults externos
- ✓ Esquemas de configuración de red y reglas de enrutamiento del reverse proxy
"¿Cuánto estado operativo puede permitirse perder el negocio como máximo?"
El RPO (Recovery Point Objective) determina cada cuánto tiempo se capturan copias y qué mecanismos de retención transaccional continua se habilitan.
- ✓ Snapshots diarios completos durante ventanas de menor tráfico operativo
- ✓ Archivado continuo de logs transaccionales (WAL / binlog) cada 5-15 minutos
- ✓ Capacidad de restauración point-in-time (PITR) hasta minutos antes del incidente
- ✓ Sincronización diferencial de almacenamiento de objetos a bucket réplica
"¿Dónde se resguardan las copias y durante cuánto tiempo se preservan?"
Un backup almacenado en el mismo servidor o datacenter que la base de datos primaria no ofrece protección ante desastres. Exigimos aislamiento geográfico.
- ✓ Almacenamiento offsite en proveedor o región geográfica independiente
- ✓ Política de retención GFS (Grandfather-Father-Son): 7 diarios, 4 semanales, 12 mensuales
- ✓ Inmutabilidad WORM (Write Once, Read Many) para protección frente a ransomware
- ✓ Cifrado con llave asimétrica antes de la transferencia al almacenamiento externo
"¿Cuánto tiempo transcurre desde que ocurre el desastre hasta que el servicio vuelve a estar en pie?"
El RTO (Recovery Time Objective) define la velocidad de recuperación. Un procedimiento manual ambiguo alarga el tiempo de caída innecesariamente.
- ✓ Runbook paso a paso con comandos exactos para provisión y montaje
- ✓ Scripts automatizados de restauración en entorno sandbox sin tocar producción
- ✓ Pruebas de conectividad de red y reconexión de pools de aplicación
- ✓ Procedimiento de conmutación (cutover) con desvío controlado de tráfico
"¿Cuándo fue la última vez que alguien restauró un backup para verificar su integridad?"
Un archivo de backup que nunca se ha probado en un servidor real no es una garantía de continuidad, es solo una esperanza no validada.
- ✓ Simulacros periódicos de restauración en entorno de staging aislado
- ✓ Verificación automatizada de consistencia de sumas de verificación (checksums)
- ✓ Comprobación de integridad de claves foráneas y conteo de registros clave
- ✓ Reporte de auditoría post-simulacro con hallazgos y tiempos de RTO reales
BACKUP AVAILABLE
Snapshot inmutable identificado en almacenamiento secundario.
SELECT POINT
Elección del timestamp exacto previo a la anomalía o corrupción.
RESTORE ISOLATED
Aprovisionamiento en red privada aislada sin interferir con producción.
VERIFY INTEGRITY
Comprobación de consistencia relacional y schemas de datos.
PROMOTE / CUTOVER
Reconexión de tráfico de aplicación con latencia y datos verificados.
Escalar no significa sobredimensionar desde el día uno.
La arquitectura más costosa no es la que usa servidores más potentes, sino la que añade capas de complejidad innecesarias antes de conocer el patrón real de demanda de tu negocio.
Simplicidad operativa y coste predecible por encima de complejidad.
Volumen de usuarios constante durante el horario laboral, sin picos extremos impredecibles ni variaciones que justifiquen infraestructura efímera.
Absorber variaciones de tráfico mediante desacoplamiento y caché perimetral.
Campañas de marketing, eventos de venta o cierres mensuales que multiplican el tráfico habitual por 5x o 20x durante lapsos de minutos u horas.
Escalar por etapas midiendo cuellos de botella antes de complejizar.
Aumento mensual progresivo de usuarios, volumen de datos y transacciones concurrentes derivado del crecimiento comercial del negocio.
Infraestructura con responsabilidades claras.
Alineamos el alcance de ingeniería para que tu equipo sepa con exactitud qué diseñamos, qué implementamos, qué automatizamos y cómo transferimos el control operativo.
Arquitectura, perímetros de red y políticas de tolerancia a fallos.
Evaluamos la demanda operativa, las dependencias y las restricciones presupuestarias para definir una topología que no sobredimensione recursos.
- ✓ Diagramas formales de topología de producción y redes privadas
- ✓ Matriz de dimensionamiento de capacidad (CPU, RAM, almacenamiento, IOPS)
- ✓ Políticas de tolerancia a fallas, timeouts y disyuntores
Entornos reproducibles, contenedores Docker y aislamiento privado.
Configuramos la infraestructura base con imágenes inmutables, subredes privadas (VPCs), balanceadores de carga y reglas de firewall perimetral.
- ✓ Contenedores Docker optimizados para producción con builds multicapa
- ✓ Configuración de reverse proxy (Nginx, Traefik o Caddy) con TLS 1.3
- ✓ Bases de datos aisladas en subred privada con pool de conexiones gestionado
Pipelines de despliegue, chequeos de salud y rollbacks seguros.
Construimos el camino desde el commit en Git hasta la producción, con validación de tests, empaquetado de artefactos y despliegues sin interrupción.
- ✓ Pipelines de CI/CD automatizados con stages de build, test y deploy
- ✓ Sondeos de preparación (readiness) y comprobaciones de humo automáticas
- ✓ Procedimiento de rollback atómico a la versión anterior si fallan los health checks
Métricas estructuradas, centralización de logs y alertas de SLIs.
Conectamos telemetría accionable para detectar degradaciones antes de que impacten a tus usuarios, correlacionando métricas, trazas y eventos.
- ✓ Dashboards operacionales con métricas RED (Rate, Errors, Duration)
- ✓ Centralización de logs estructurados en JSON con Request ID inyectado
- ✓ Reglas de alerta calibradas basadas en síntomas de usuario reales, sin fatiga
Runbooks paso a paso, inventario de variables y procedimientos de contingencia.
Sin conocimientos ocultos ni dependencias de una sola persona. Cada procedimiento de despliegue, reinicio o contingencia queda escrito con comandos exactos.
- ✓ Libros de ejecución (runbooks) para resolución de incidencias comunes
- ✓ Documentación detallada de variables de entorno, secretos y dependencias
- ✓ Plan de continuidad operativa con procedimientos de restore cronometrados
Soberanía absoluta: tu repositorio, tus cuentas y control total de tu equipo.
No retenemos llaves maestras ni te atamos a licencias cautivas. El código, los scripts de infraestructura y las credenciales pertenecen 100% a tu empresa.
- ✓ Infraestructura como código versionada en tu propio repositorio Git
- ✓ Cuentas y facturación directa con los proveedores que elijas
- ✓ Sesiones de transferencia técnica y capacitación a tu equipo interno
Transparencia en Acompañamiento y Disponibilidad
No prometemos un NOC 24/7 genérico si tu servicio no lo requiere. Entregamos observabilidad activa, alertas de SLIs y runbooks para que tu equipo pueda actuar de inmediato. El esquema de soporte y guardias se define contractualmente según las necesidades de tu plataforma.
Del diagnóstico inicial a la operación continua: un camino metódico.
Cada proyecto de infraestructura atraviesa etapas estructuradas con entregables verificables en tu propio repositorio desde el primer día.
Auditoría de la situación actual, dependencias y riesgos de infraestructura.
Analizamos cómo corre el sistema hoy: servidores, despliegues manuales, puntos únicos de fallo, dependencias externas, estado de copias de seguridad y costes actuales.
- ✓ Inventario detallado de servicios, puertos expuestos y certificados
- ✓ Revisión de los flujos actuales de compilación y despliegue
- ✓ Identificación de puntos únicos de fallo (SPOF) y riesgos perimetrales
- ✓ Auditoría del estado real de backups y políticas de retención de datos
Reporte de Diagnóstico de Riesgos & Prioridades
Documento de auditoría técnica con mapa de situación actual y matriz de acciones prioritarias.
Arquitecturas desplegadas para operar con estabilidad bajo carga.
Decisiones de infraestructura tomadas en plataformas reales donde la consistencia de datos, la velocidad de despliegue y la continuidad operativa son críticas para el negocio.
Plataforma Headless de Alto Tráfico con Edge Caching & Desacoplamiento
Sector: Comercio Electrónico B2B y Consumo Masivo
Tienda online con catálogos extensos y campañas publicitarias masivas que saturaban la base de datos cada vez que se lanzaban promociones con alto tráfico concurrente.
Presupuesto mensual fijo que impedía escalar servidores a clusters sobredimensionados; necesidad de mantener tiempos de respuesta menores a 200ms en el checkout.
Diseño de arquitectura con capa de edge reverse proxy agresivo para activos y respuestas públicas, separación de APIs transaccionales y pool de conexiones PgBouncer para proteger PostgreSQL.
Contenedores inmutables en red privada con despliegue rolling, sondas de preparación automatizadas y logs estructurados correlacionados por Request ID.
Infraestructura Aislada en Red Privada para Procesamiento Financiero
Sector: Servicios Financieros y Facturación B2B
Plataforma transaccional de pagos y conciliación bancaria que requería cumplimiento estricto de seguridad, cifrado de datos en reposo y cero exposición de servidores de base de datos a internet.
Regulaciones estrictas de privacidad y auditoría; necesidad de garantizar recuperación point-in-time ante corrupción de datos con RTO menor a 30 minutos.
Aprovisionamiento de subred privada aislada (VPC) sin IPs públicas en los nodos de base de datos, túnel VPN con MFA para tareas administrativas y archivado continuo de logs transaccionales (WAL).
Rotación automática de secretos inyectados en memoria, cifrado AES-256 en reposo, simulacros periódicos de restauración y registro inmutable de auditoría.
Plataforma SaaS con Despliegues Atómicos y Rollback Automatizado
Sector: Software Empresarial de Gestión Logística
Aplicación SaaS con cientos de empresas operando simultáneamente durante todo el día, donde cada despliegue manual generaba interrupciones y temor en el equipo de desarrollo.
Equipos de ingeniería desplegando múltiples veces por semana; prohibición de cortes de servicio o sesiones de usuario caídas durante las actualizaciones de código.
Implementación de pipeline CI/CD automatizado con verificación de pruebas unitarias, compilación de imágenes Docker inmutables y despliegue rolling con drenado de conexiones.
Health probes que bloquean automáticamente la promoción de versiones inestables, rollback inmediato sin intervención humana y dashboards de observabilidad con métricas RED.
Respuestas directas sobre proveedores, alcance y operación.
Criterios esenciales sobre compatibilidad, gobernanza de datos, observabilidad y reducción de costes antes de iniciar un proyecto de infraestructura.
01 ARQUITECTURA ¿Trabajan solo con un proveedor cloud específico?
¿Trabajan solo con un proveedor cloud específico?
No. La arquitectura se decide según el producto, las capacidades del equipo, las restricciones de presupuesto y las necesidades operativas reales. Evaluamos e implementamos soluciones en entornos como AWS, Cloudflare, Contabo, Vercel, servidores dedicados o configuraciones híbridas. Nuestro servicio no depende de forzar un proveedor por defecto ni de vender licencias.
02 AUDITORÍA ¿Pueden auditar y mejorar infraestructura que ya está corriendo?
¿Pueden auditar y mejorar infraestructura que ya está corriendo?
Sí. Gran parte de nuestros proyectos comienzan sobre sistemas existentes en producción. Realizamos una auditoría técnica completa evaluando el proceso de despliegue, la superficie de exposición perimetral, la telemetría disponible, la seguridad de secretos y la integridad de las copias de seguridad para definir un plan de mejoras por etapas sin paralizar tu operación.
03 CRITERIO TÉCNICO ¿'Cloud' significa obligatoriamente migrar todo a AWS?
¿'Cloud' significa obligatoriamente migrar todo a AWS?
No. 'Cloud & Infrastructure' describe capacidades operativas (despliegue reproducible, observabilidad, seguridad perimetral y recuperación), no un logotipo comercial específico. Para muchas plataformas, un cluster de servidores dedicados o VPS bien configurados ofrece mejor rendimiento, menor latencia y un coste 70% inferior a una arquitectura hipercompleja en un proveedor público masivo.
04 AUTOMATIZACIÓN ¿Implementan pipelines de CI/CD automatizados?
¿Implementan pipelines de CI/CD automatizados?
Sí, cuando el proyecto cuenta con un flujo de desarrollo de software activo. El objetivo no es simplemente instalar una herramienta, sino diseñar un camino confiable y determinista: compilación limpia, ejecución obligatoria de pruebas, generación de imágenes inmutables y despliegues con chequeos de salud automatizados que ejecutan rollback inmediato si algo degrada.
05 CONTINUIDAD ¿Cómo garantizan que los backups realmente funcionen?
¿Cómo garantizan que los backups realmente funcionen?
La continuidad operativa no termina al programar una copia automática. Diseñamos políticas de respaldo que contemplan qué datos se resguardan, frecuencia de captura (RPO), retención geográfica fuera de sitio (offsite) y, fundamentalmente, simulacros periódicos de restauración cronometrados (RTO) en entornos sandbox aislados para certificar que los datos se recuperan sin corrupción.
06 OPERACIÓN ¿Ofrecen monitoreo y atención 24/7?
¿Ofrecen monitoreo y atención 24/7?
No prometemos un centro de operaciones (NOC) 24/7 universal si tu contrato no lo contempla. Lo que implementamos en todos los proyectos es observabilidad de primer nivel: instrumentación de métricas de usuario (RED), centralización de logs estructurados, correlación de trazas y alertas contextuales con runbooks documentados. El modelo de guardia, atención y soporte operacional se acuerda de forma transparente según las necesidades críticas de tu negocio.
07 OPTIMIZACIÓN ¿Pueden ayudar a reducir la factura de mi proveedor cloud?
¿Pueden ayudar a reducir la factura de mi proveedor cloud?
Sí. Revisamos el dimensionamiento de recursos, instancias ociosas, patrones de tráfico, transferencias de datos no optimizadas y servicios sobrecargados. Con frecuencia, implementar una capa de caché perimetral eficiente y optimizar pools de base de datos permite reducir drásticamente el consumo computacional sin sacrificar rendimiento.
08 METODOLOGÍA ¿Qué información o accesos necesitan para iniciar una auditoría?
¿Qué información o accesos necesitan para iniciar una auditoría?
Comenzamos con una sesión técnica de descubrimiento: revisamos los diagramas actuales, el flujo de deploy, el inventario de servicios y el historial de incidencias recientes. Para el análisis profundo, requerimos accesos de solo lectura con mínimo privilegio a la consola del proveedor y al repositorio de código, resguardados bajo acuerdos estrictos de confidencialidad (NDA).
La interfaz también forma parte de la arquitectura.
Diseñamos superficies que ayudan a operar: jerarquía clara, estados comprensibles, navegación rápida y una experiencia consistente entre escritorio y móvil.
Arquitectura
Capas técnicas pensadas para evolucionar sin rehacer el producto.
Workspace
Producto, arquitectura y operación en una misma superficie.
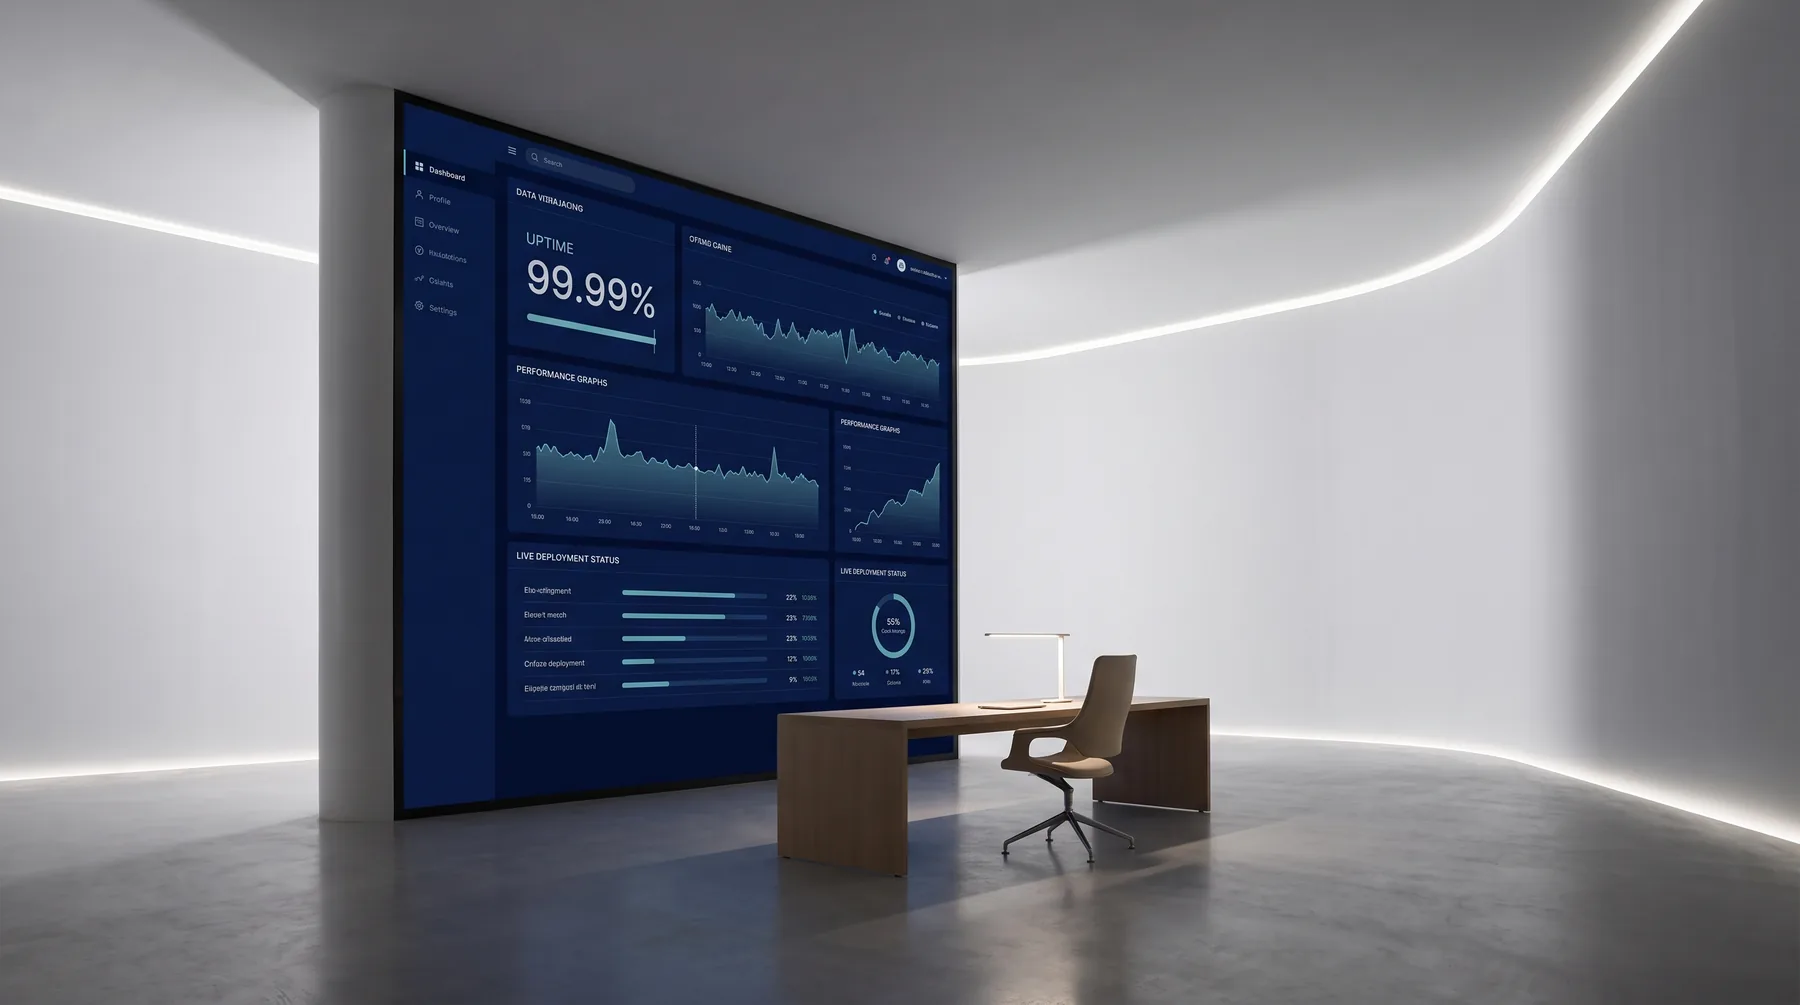
Operación conectada
Flujos, datos y señales en tiempo real.
Desliza para ver más interfaces →
Antes de escalar infraestructura, entendamos dónde está el riesgo.
Revisemos despliegue, exposición perimetral, observabilidad, backups y capacidad de recuperación para identificar qué conviene corregir primero sin sobredimensionar costes.